
Apa Itu Cache Prompt GPT-6 dan Mengapa Ia Penting
Cache prompt GPT-6 ialah mekanisme yang menyimpan konteks input yang dikongsi antara permintaan API supaya pengiraan boleh digunakan semula, mengurangkan pemprosesan berulang, memendekkan masa respons dan memberikan diskaun besar untuk token input yang disimpan dalam cache, sekali gus membantu aplikasi AI mencapai latensi lebih rendah dan kos operasi lebih terkawal.
Intipatinya: jika anda abaikan cache prompt GPT-6, anda membazir wang dan masa pengguna. OpenAI bukan sekadar menambah ciri kecil; mereka melancarkan sistem cache prom yang dipertingkatkan dengan kadar padanan cache lalai yang lebih tinggi. Ini bermakna lebih banyak bahagian prom boleh digunakan semula tanpa dikira semula. Dalam aplikasi berasaskan ejen yang menghantar siri permintaan dengan arahan dan konteks sama, kesannya dramatik: token prom yang perlu diproses semula boleh turun lebih 50% merentas berbilion-bilion permintaan. Jika matlamat anda ialah latensi rendah ChatGPT dan bil API yang masuk akal, cache bukan lagi pilihan – ia strategi wajib.
Fitur Cache Baharu: Kurangkan Pemprosesan Berulang, Tingkatkan Kawalan
Kekuatan sebenar cache prompt GPT-6 terletak pada kadar padanan yang semakin tinggi dan kawalan yang jauh lebih halus. Sistem baharu memberikan diskaun bagi awalan dikongsi yang layak dan digunakan semula dalam tempoh 30 minit, sambil mengurangkan masa respons serta menawarkan diskaun sehingga 90% bagi token input yang disimpan dalam cache. Dengan kata lain, semakin besar bahagian prom yang berulang, semakin besar penjimatan yang anda raih.
Tambahan penting lain ialah set alat diagnostik dan pemantauan. Papan Pemuka Cache Prom menunjukkan bahagian input aplikasi yang disediakan daripada cache dan membolehkan anda jejaki kadar padanan dari semasa ke semasa. Apabila padanan gagal tanpa dijangka, alat diagnostik cache prom mendedahkan punca – sama ada model, alat, tetapan atau input berubah – serta menganggarkan bilangan token yang terjejas. Titik henti cache eksplisit pula membenarkan anda memilih awalan prom yang hendak digunakan semula. Gabungan ini bermaksud anda tidak lagi bermain teka-teki; anda boleh mengawal penggunaan cache secara tepat, bukan sekadar berharap sistem “pandai-pandai sendiri”.
Optimasi Parameter AI: Dari Usaha Penaakulan ke Pramuat Cache
Jika objektif anda adalah latensi rendah ChatGPT dan penjimatan, cara anda tetapkan parameter AI di sekeliling cache adalah penentu. GPT-6 membenarkan anda memilih kandungan prom yang disimpan melalui titik henti cache eksplisit, jadi hanya bahagian yang berulang benar-benar dimasukkan ke dalam cache. Kawalan pilihan ini melengkapi prestasi lalai enjin dan membantu anda menyesuaikan cache dengan beban kerja anda.
Lebih menarik, anda boleh melaraskan usaha penaakulan antara respons tanpa mengganggu cache: tingkatkan untuk tugas sukar, rendahkan bagi susulan rutin, sambil mengekalkan usaha penaakulan peringkat permintaan dan konteks boleh guna semula. Di peringkat latensi, pramuat cache membenarkan konteks diketahui lebih awal disediakan sebelum pengguna bertanya, mengurangkan kependaman kerana pemprosesan dialihkan keluar daripada tempoh menunggu pengguna. Jika anda serius tentang optimasi parameter AI, anda sepatutnya memikirkan cache, usaha penaakulan dan pramuat sebagai satu pakej strategi, bukan tiga ciri terasing.
Kurangkan Kos API: Kombinasi Cache dan Model GPT-6 Sol & Luna
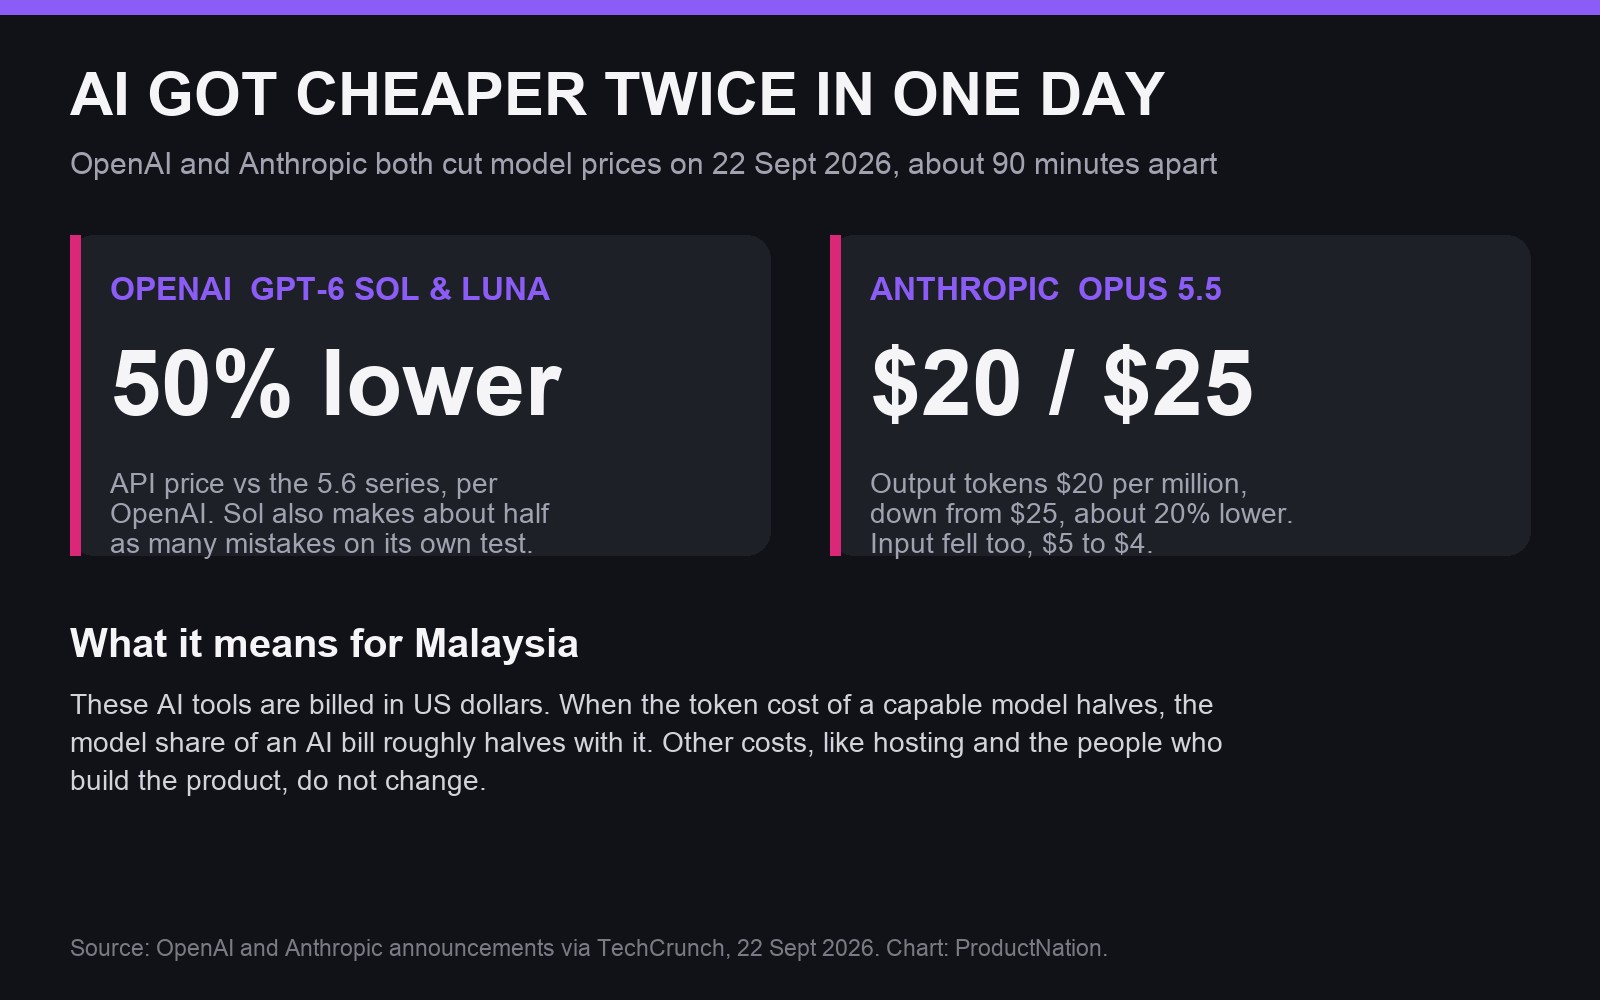
Cache yang baik sahaja tidak cukup jika model yang digunakan terlalu mahal. Di sini GPT-6 Sol dan GPT-6 Luna mengubah kiraan. Kedua-duanya kira-kira separuh lebih murah untuk digunakan melalui API berbanding versi 5.6 yang terdahulu, dengan harga API sekitar 50 peratus lebih rendah berbanding harga sebelumnya. Potongan ini dikaitkan secara jelas kepada caching yang lebih baik serta pemprosesan yang lebih cekap. Apabila kos token untuk menjalankan model menjadi separuh, bahagian model dalam bil AI juga menjadi kira-kira separuh.
Kesan gabungan antara model lebih murah dan cache prompt GPT-6 yang dioptimumkan sukar dinafikan. Dalam penilaian dalaman, kadar padanan cache boleh meningkat daripada sekitar pertengahan 80% ke lebih 90%, sekali gus menurunkan lagi kos inferens. Dalam masa kurang seminggu, kadar padanan cache dalam satu penilaian meningkat daripada 83% kepada 91%, mengurangkan penulisan cache kira-kira dua pertiga dan menurunkan kos inferens 36% untuk beban kerja yang sama. Jika anda tidak menggabungkan potongan harga Sol/Luna dengan konfigurasi cache agresif, anda pada dasarnya meninggalkan diskaun di atas meja.
Kesimpulan: Anggap Cache Sebagai Infrastruktur, Bukan Ciri Sampingan
Cache prompt GPT-6 bukan “nice-to-have” untuk projek AI moden; ia infrastruktur kos dan prestasi. Dengan keupayaan menyimpan konteks dikongsi untuk digunakan semula merentas permintaan, pengurangan masa respons dan diskaun sehingga 90% bagi token input yang disimpan dalam cache, sesiapa yang mengabaikannya sedang membakar bajet tanpa sebab.
Diagnostik baharu, papan pemuka cache, titik henti eksplisit, pelarasan usaha penaakulan dan pramuat cache menjadikan optimasi parameter AI sesuatu yang boleh diurus dengan angka, bukan firasat. Apabila semua ini digabungkan dengan model GPT-6 Sol dan Luna yang membawa harga API kira-kira 50 peratus lebih rendah berbanding 5.6, strategi yang masuk akal ialah jelas: anggap cache sebagai komponen utama seni bina, ukur kadar padanan anda, dan kejar latensi serta kos yang semakin rendah secara berterusan. Dalam dunia di mana setiap token dikira, disiplin terhadap cache adalah kelebihan kompetitif, bukan sekadar tweak teknikal.