
Mengapa Potongan Harga GPT-6 Penting dan Apa Maksudnya untuk Kos API
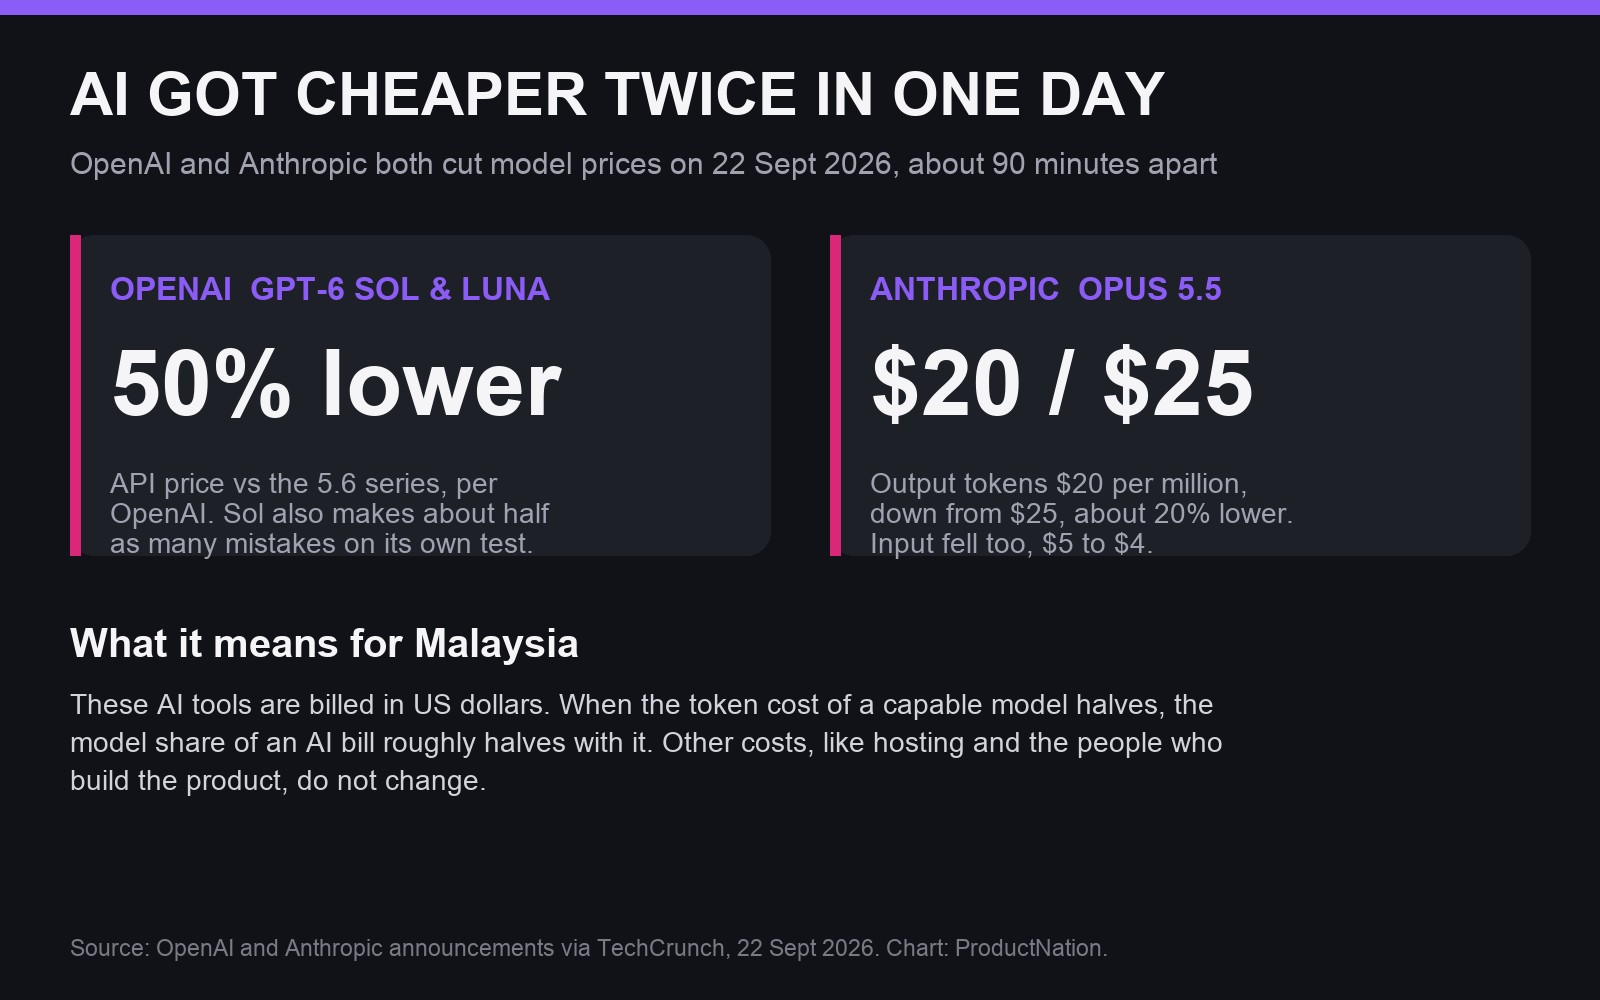
Potongan harga model GPT-6 ialah peluang strategik untuk pembangun dan peniaga mengurangkan kos API sambil mengekalkan prestasi, melalui gabungan model baharu lebih murah, caching prompt GPT-6 yang lebih pintar dan optimasi parameter AI yang mengurangkan penjimatan token AI yang terbuang dalam permintaan berulang. OpenAI melancarkan GPT-6 Sol dan GPT-6 Luna, kedua-duanya kira-kira separuh lebih murah untuk digunakan berbanding versi 5.6 melalui API, hasil caching lebih baik dan pemprosesan lebih cekap. Apabila kos token untuk menjalankan model yang berupaya menjadi separuh, bahagian model dalam bil AI turut menjadi kira-kira separuh. Bagi produk yang modelnya adalah perbelanjaan utama, penjimatan ini bukan teori; ia boleh menentukan sama ada ciri AI wajar diteruskan atau digugurkan. Pasukan kecil yang sebelum ini teragak-agak kini mempunyai sebab baharu untuk “mengira semula” pelan AI mereka.
Pandangan kritikal di sini: potongan 50% bukan alasan untuk boros, tetapi ruang untuk berdisiplin. Jika aplikasi tetap menghantar prompt berulang tanpa caching prompt GPT-6 yang betul, bil token akan naik semula dan menelan potongan harga itu. Sebaliknya, siapa yang mula dari awal dengan reka bentuk prom yang terancang boleh menjadikan GPT-6 Sol sebagai mesin tugas berat seperti pengekodan, dan Luna sebagai enjin volum tinggi seperti ringkasan dokumen dan jawapan pantas, dengan kos API yang jauh lebih terkawal.
Caching Prompt GPT-6: Jantung Penjimatan Token AI
Caching prompt GPT-6 ialah teknik menyimpan konteks perkongsian permintaan API supaya pengiraan boleh digunakan semula merentas panggilan seterusnya, sekali gus mengurangkan masa respons dan membantu kurangkan kos API melalui penjimatan token AI yang tidak perlu diproses semula. GPT‑6 menyokong ejen berterusan yang melaksanakan tugas rumit berjam-jam, dengan aplikasi lazimnya mengulang arahan, takrif alat dan konteks yang sama. OpenAI menyimpan konteks dikongsi itu dalam cache untuk menggunakan semula pengiraan, mengurangkan masa respons dan memberikan diskaun sehingga 90% bagi token input yang disimpan dalam cache. Bersama keluarga GPT‑6, sistem cache prom dipertingkatkan untuk memberikan kadar padanan cache lalai yang lebih tinggi.
Hakikatnya, setiap token yang tidak perlu diproses semula ialah wang yang tidak dibakar. Contoh nyata: satu aplikasi besar melaporkan bahawa mereka berjaya mengurangkan bahagian token prom yang perlu diproses semula lebih 50% merentas berbilion permintaan kepada model OpenAI berbanding garis dasar sebelumnya. Dalam masa kurang seminggu, kadar padanan cache model mereka naik daripada kira-kira 85% kepada lebih 90% secara konsisten, sekali gus mengurangkan lagi kos inferens dalam pengeluaran. Jika mereka boleh capai angka sebegitu, tidak ada alasan teknikal mengapa sistem anda sendiri tidak boleh diarahkan ke kadar padanan cache tinggi yang sama.
Titik Henti Cache dan Diagnostik: Senjata Mencari Kebocoran Kos
Jika caching ialah jantung penjimatan, kawalan diagnostik ialah mata yang memantau kebocoran kos. Sistem GPT-6 baharu tidak sekadar menyimpan prom dalam cache; ia memberikan pembangun papan pemuka dan alat analisis khusus. Papan Pemuka Cache Prom menunjukkan bahagian input aplikasi yang datang daripada cache, menjejak kadar padanan dari semasa ke semasa dan membandingkan token disimpan dan tidak disimpan dalam cache. Paparan ini membolehkan anda mengesan penurunan padanan cache dan menilai kesan perubahan aplikasi terhadap prestasi cache.
Apabila berlaku kegagalan padanan cache yang tidak dijangka, alat diagnostik cache prom membantu memahami punca, dengan membandingkan permintaan dengan respons terkini untuk mengenal pasti perubahan pada model, alat, tetapan atau input yang menghalang penggunaan semula. Titik henti cache eksplisit pula membolehkan anda memilih awalan prom yang hendak digunakan semula. Dalam bahasa mudah: anda memilih bahagian konteks yang patut kekal, dan sistem menunjukkan di mana ia tiba-tiba tidak lagi digunakan. Bagi pembangun yang serius mengawal bajet, ini ialah radar kebocoran kos—abaikan radar, bersedialah menanggung bil token yang tidak dijangka.
Optimasi Parameter AI: Laraskan Usaha Penaakulan Tanpa Menggugat Cache
Ramai pembangun faham tentang caching, tetapi lupa bahawa optimasi parameter AI sama penting untuk kurangkan kos API. Pada model GPT‑6, anda boleh mengubah usaha penaakulan antara respons tanpa mengganggu cache. Ini bermakna tahap “kecerdasan” yang digunakan boleh disesuaikan dengan tugas semasa. Anda boleh tingkatkan usaha untuk tugas lebih sukar atau kurangkannya bagi susulan rutin dengan menambahkan configuration_update sambil mengekalkan usaha penaakulan peringkat permintaan tanpa perubahan. Kawalan pilihan ini melengkapi prestasi lalai enjin dan membantu anda menyesuaikan cache dengan beban kerja anda.
Pendekatan berdisiplin ialah: jangan guna mod penaakulan tinggi untuk setiap panggilan hanya kerana ia wujud. Gunakan parameter yang lebih ringan untuk operasi ulangan dan simpan mod berat untuk situasi kritikal. Pada masa sama, kekalkan kestabilan takrif, skema dan susunan alat supaya konteks terdahulu boleh terus digunakan semula walaupun keperluan penggunaan alat berubah. Dengan langkah ini, sistem boleh mengekalkan cache apabila alat dan arahan berubah, sambil penggunaan token untuk penaakulan ditahan pada tahap wajar. Gabungan cache stabil dan usaha penaakulan yang disasar ialah formula praktikal untuk penjimatan token AI jangka panjang, bukan cuma penjimatan sementara.
Strategi Praktis: Dari Pramuat Cache ke Belanjawan AI yang Terkawal
Pada tahap operasi, kurangkan kos API memerlukan keputusan reka bentuk yang sengaja, bukan berharap kepada potongan harga semata-mata. Dengan GPT‑6, anda boleh pramuat cache untuk mengurangkan kependaman, menyediakan konteks yang diketahui lebih awal seperti arahan dikongsi, takrif alat atau bahan rujukan semasa permulaan sebelum pengguna mengemukakan soalan pertama. Ini mempercepat respons sambil mengelak penulisan cache berulang untuk maklumat statik. Pasukan yang menjadikan model sebagai perbelanjaan utama kini mempunyai ruang yang nyata untuk mengoptimumkan belanjawan AI; bagi mereka, potongan kos token boleh menjadi angka penentu sama ada ciri AI dilaksanakan atau tidak. Pasukan yang menangguhkan ciri AI kerana kos yang tidak masuk akal mempunyai sebab baharu untuk mengira semula.
Kesimpulannya, GPT‑6 Sol dan Luna memang menawarkan API pada separuh kos berbanding model sebelumnya, tetapi manfaat sebenar hanya muncul apabila anda: mengatur promp yang konsisten untuk kadar padanan cache tinggi, menggunakan titik henti dan diagnostik bagi memburu kebocoran kos, melaras usaha penaakulan berdasarkan tugas, serta mempramuat konteks yang relevan. Kos AI kini lebih rendah, namun disiplin teknikal menentukan sama ada penjimatan itu masuk ke dalam akaun anda atau hilang bersama token yang diproses tanpa sebab. Pilih untuk serius tentang cache dan parameter, dan belanjawan AI anda akan jauh lebih terkawal.